平时大家用 AI 做项目,是不是经常遇到一个抓狂的时刻:项目越做越多,代码和文档散落在本地各个文件夹里。过两个月,你想接着之前的进度干,别说找文件了,连当时的逻辑都想不起来。
更难受的是,当你把需求发给 AI,指望它帮你干活时,AI 却像个没有记忆的工具人,完全不知道你上一步做到哪了。
今天,老张把底牌亮出来,看看老张是怎么用 WorkBuddy 的「资料库」功能,把散落的经验变成随时能调用的“数字资产”的。
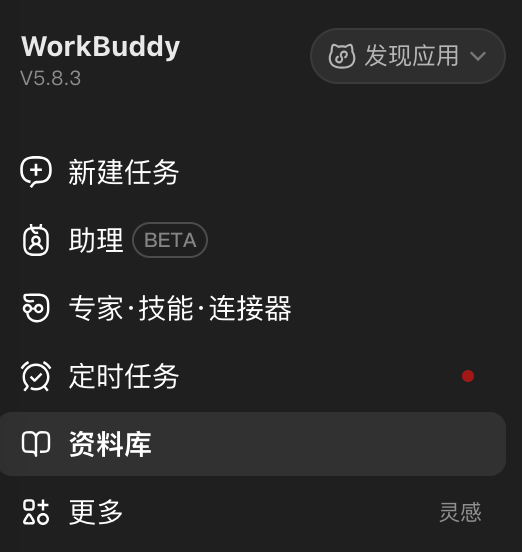
打开 WorkBuddy,在左侧导航栏找到「资料库」。很多朋友平时只点“新建任务”,却忽略了这个极其重要的资产沉淀区。
为什么是“云端”而不是“本地”?
很多人习惯把资料存在本地电脑里。但本地有个致命弱点——那是“死数据”。你如果不主动打开、不主动发给 AI,AI 就完全看不见。
老张选择把资料存进云端资料库,核心诉求就两个:一是随时能被 AI 调用,二是多项目好管理。
看看老张的资料库总览就明白了。
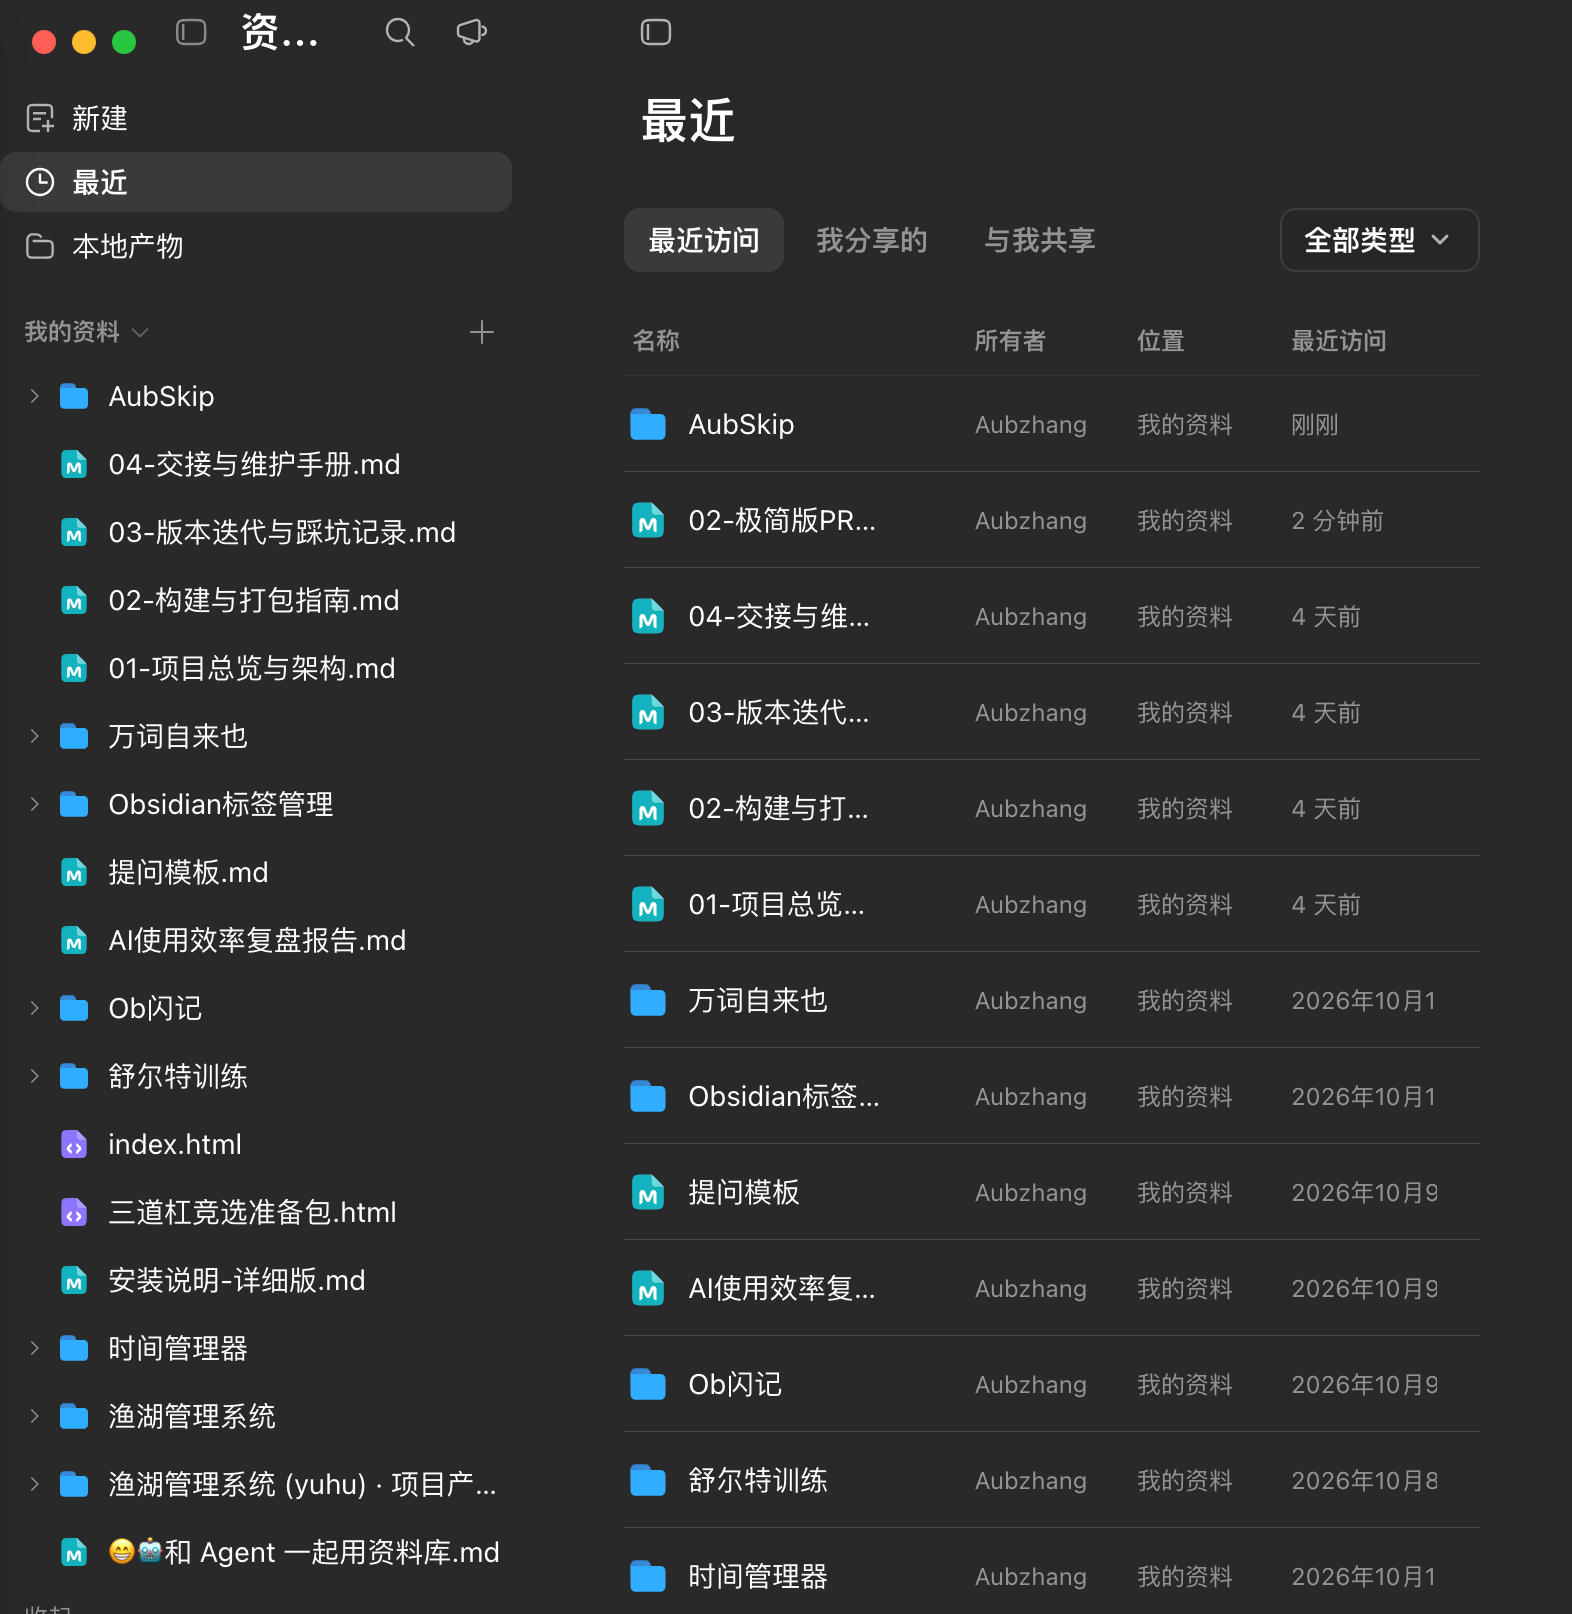
这里面分门别类地建了「AubSkip」、「万词自来也」、「时间管理器」等文件夹,甚至还有咱们前几期讲过的《提问模板》和《AI使用效率复盘报告》。看一眼左下角,老张已经使用了 325.98 MB 的云端空间。
这样存的好处是:老张无论是在写文章,还是让 AI 帮忙改代码,这些资料随时都能被精准调取,不再是一个个躺在硬盘里的死文件。
老张的资料管理心法:既要懂人,也要懂 AI
存进去只是第一步,怎么管理才是大学问。看看老张的 AubSkip 项目文件夹。
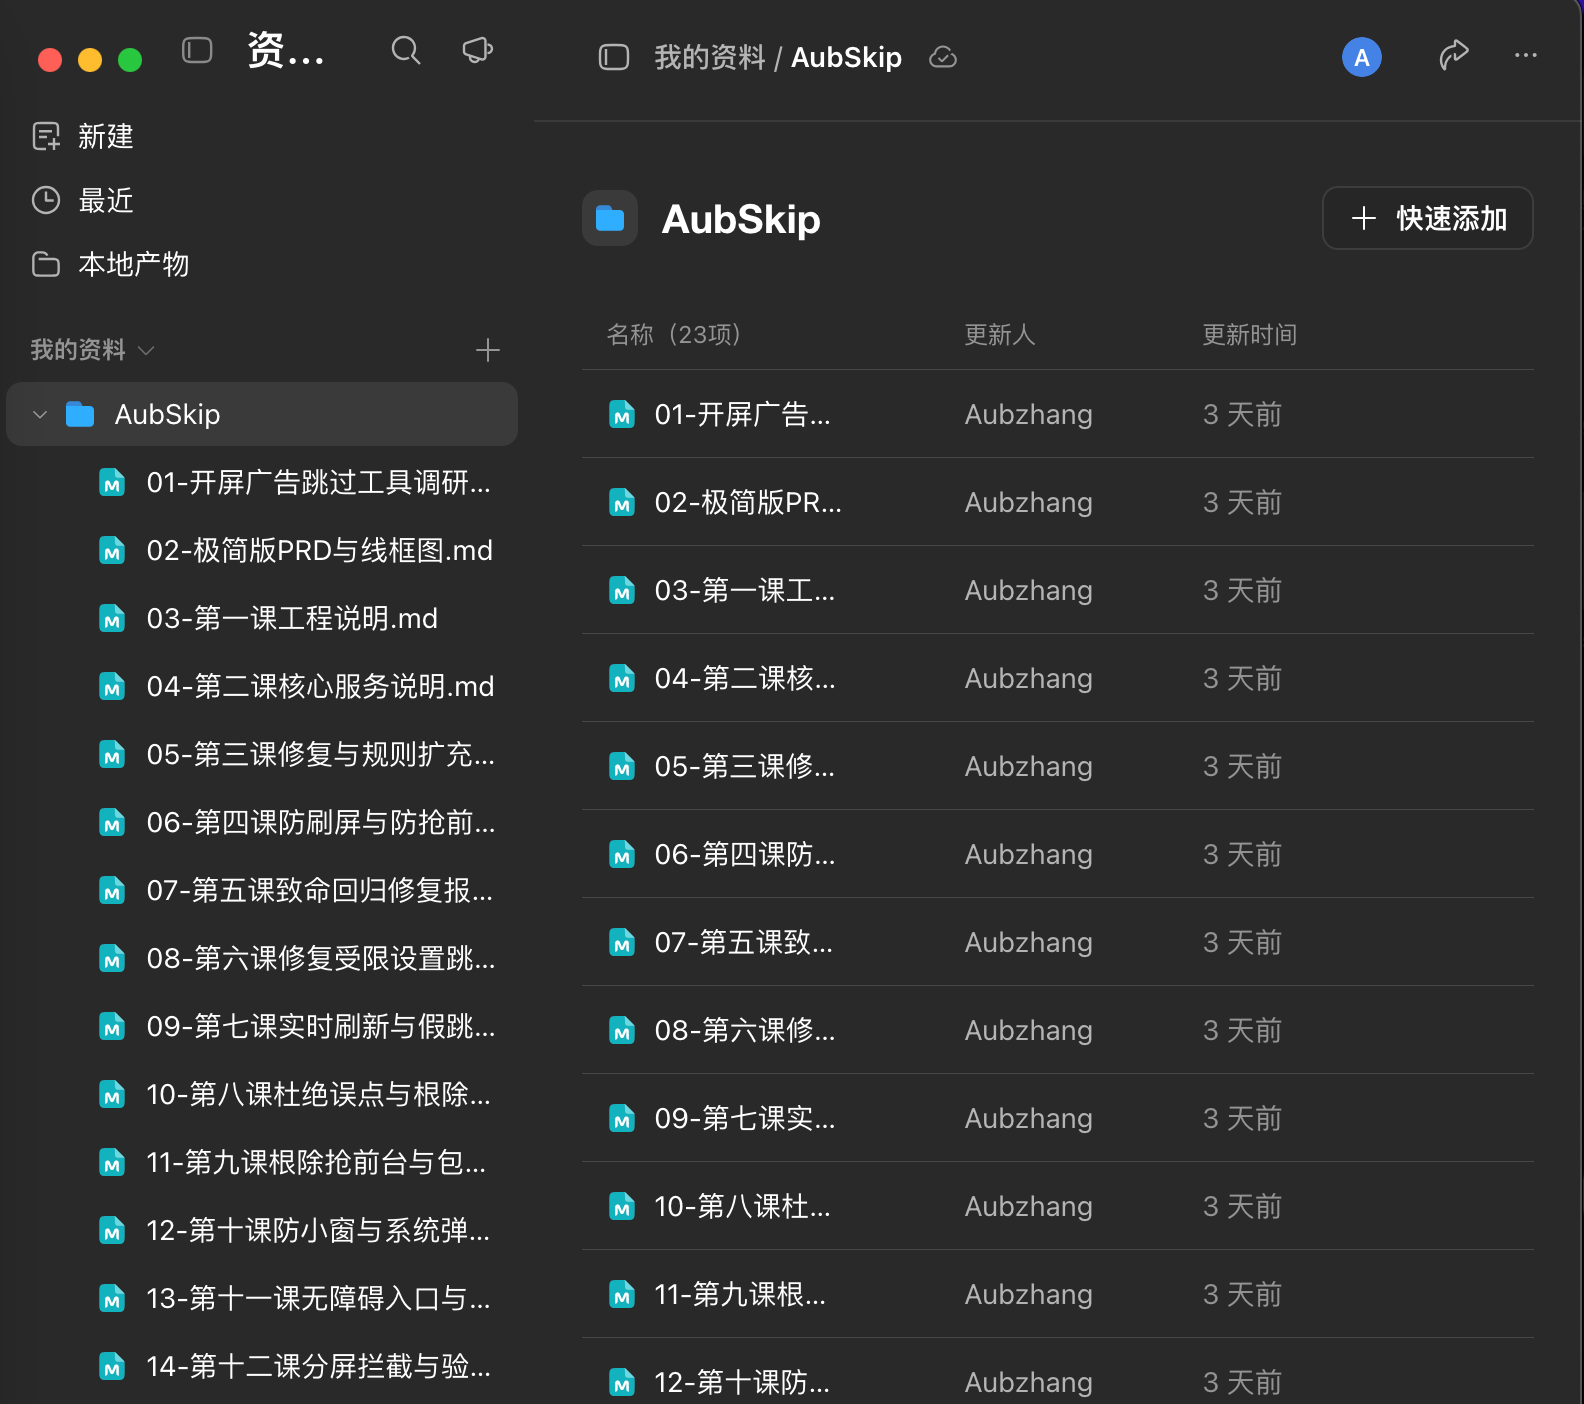
大家注意看老张的命名规范:
从 01-开屏广告跳过工具调研、02-极简版PRD与线框图,到后面的核心服务说明、防刷屏逻辑、致命回归修复报告……整整 23 份文档,全部以数字序号 + Markdown(.md)格式打头。
为什么老张要这么较真?
- 懂人:一眼看过去,项目的迭代脉络清清楚楚,永远按顺序来,绝不会乱。
- 懂 AI:AI 对 Markdown 格式极其敏感。当老张让 AI 去“修复一个抢前台的 bug”时,AI 扫一眼目录,瞬间就能定位到
11-第九课根除抢前台...。这就是规范的沉淀带来的极致效率。
沉淀的不仅是文字,更是“上下文”
如果只是建个文本存两句话,那叫备忘录,不叫资料库。看看老张是怎么写文档的。
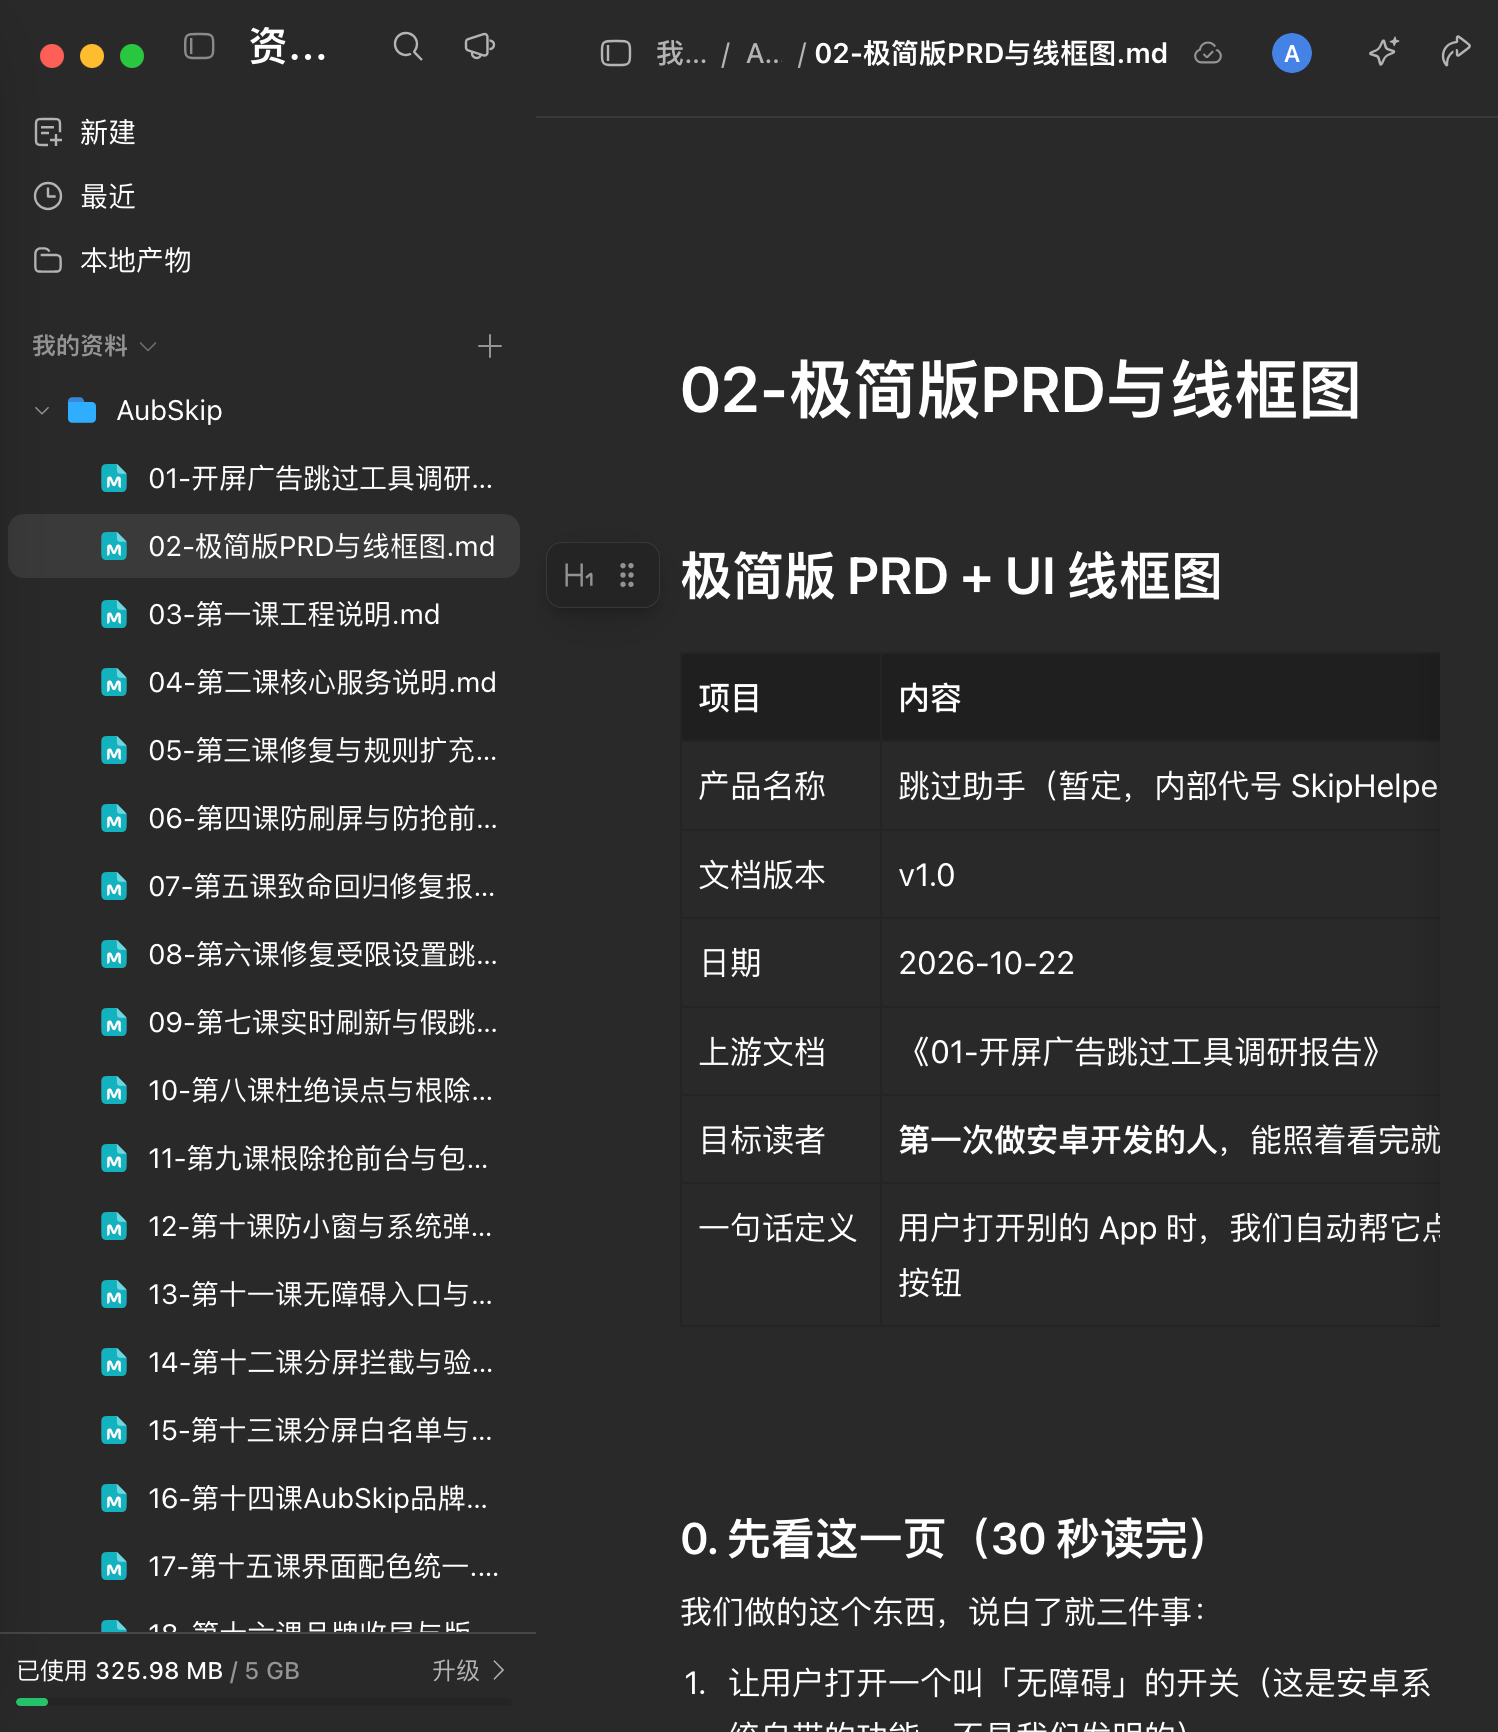
这是老张写的《02-极简版 PRD 与线框图》,里面包含了文档版本、日期、上游文档链接、目标读者。最关键的,老张写了一句“一句话定义”:用户打开别的 App 时,我们自动帮他点按钮。
老张为什么要费这么大劲写这些?
因为当未来你需要 AI 帮你扩展新功能时,把这份文档丢给它,AI 瞬间就能理解你的产品哲学、你的边界、你的上下文。 你甚至不需要写长串的 Prompt,一份好的沉淀文档,胜过千言万语。
一键唤醒:资料库的终极威力
讲的都是怎么存,那用起来到底有多爽?老张给大家看一个真实的实战案例。
假设今天老张想给 AubSkip 做个大优化,老张不需要长篇大论地给 AI 复述背景,只需要在新建任务时,输入这样一句话:
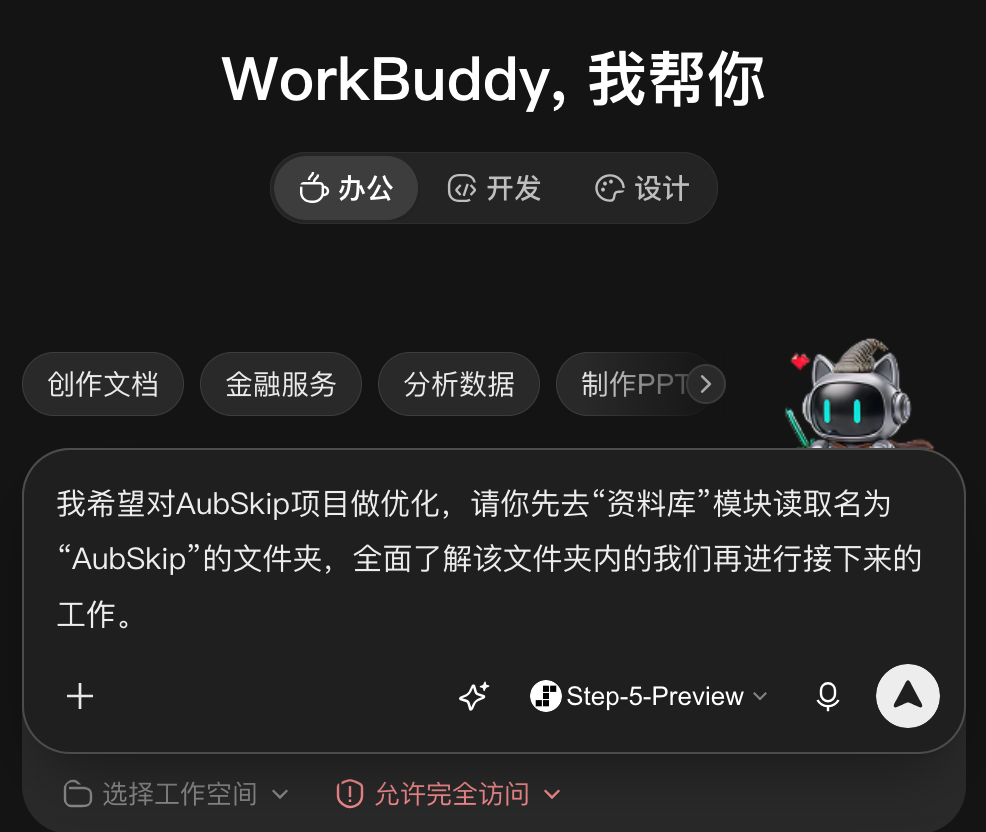
“我希望对 AubSkip 项目做优化,请你先去‘资料库’模块读取名为‘AubSkip’的文件夹,全面了解该文件夹内的文档,我们再进行接下来的工作。”
指令发出去,WorkBuddy 就会像开了挂一样,自己去云端库房里翻箱倒柜。
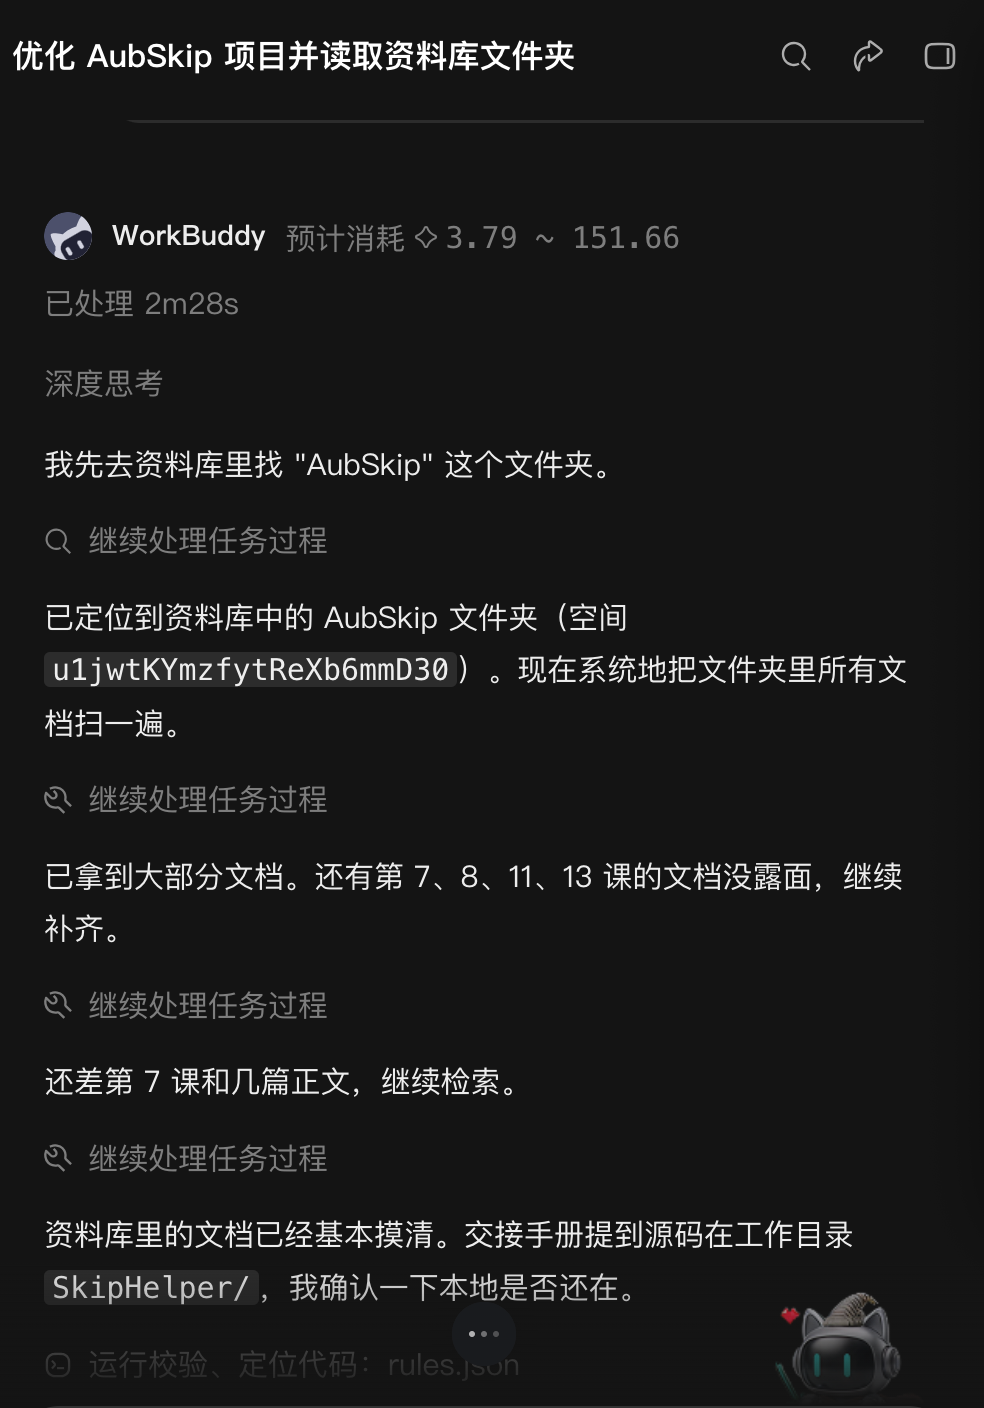
看看它的执行过程:
它精准定位到了 AubSkip 文件夹,系统地把所有文档扫了一遍。发现第 7、8、11、13 课的文档没露面,还会主动继续检索补齐。最后不仅摸清了文档,还根据交接手册的提示,定位到了本地的工作目录 SkipHelper/,为后续写代码做好了准备。
这就是资料库最大的魅力:你只需给出一个方向,AI 会自己带着你过去的经验和记忆,补齐所有的上下文。
写在最后
老张之所以费这么大劲去建资料库,是因为老张坚信一点:把项目资料结构化地沉淀下来,不仅是在整理文件,更是在建立你自己的“外脑”。
很多人用 AI,天天在开新坑,做完就忘。但时间久了你会发现,真正拉开差距的,不是谁 Prompt 背得多,而是谁沉淀下来的经验更完整。
把记忆交给云端,把上下文留给 AI,把思考留给自己。真正拉开差距的,是你沉淀下来的经验。有了这个资料库,以后再大的项目,也能随时无缝衔接。